La inteligencia artificial está cambiando la forma en que las empresas consultan, transforman y utilizan sus datos. Hoy es posible preguntar a un modelo de lenguaje cuánto ha facturado una compañía, qué clientes generan más beneficios o qué productos están perdiendo rentabilidad y obtener una consulta SQL en cuestión de segundos. Sin embargo, hay una diferencia fundamental entre generar una consulta que funciona y obtener una respuesta correcta para el negocio.
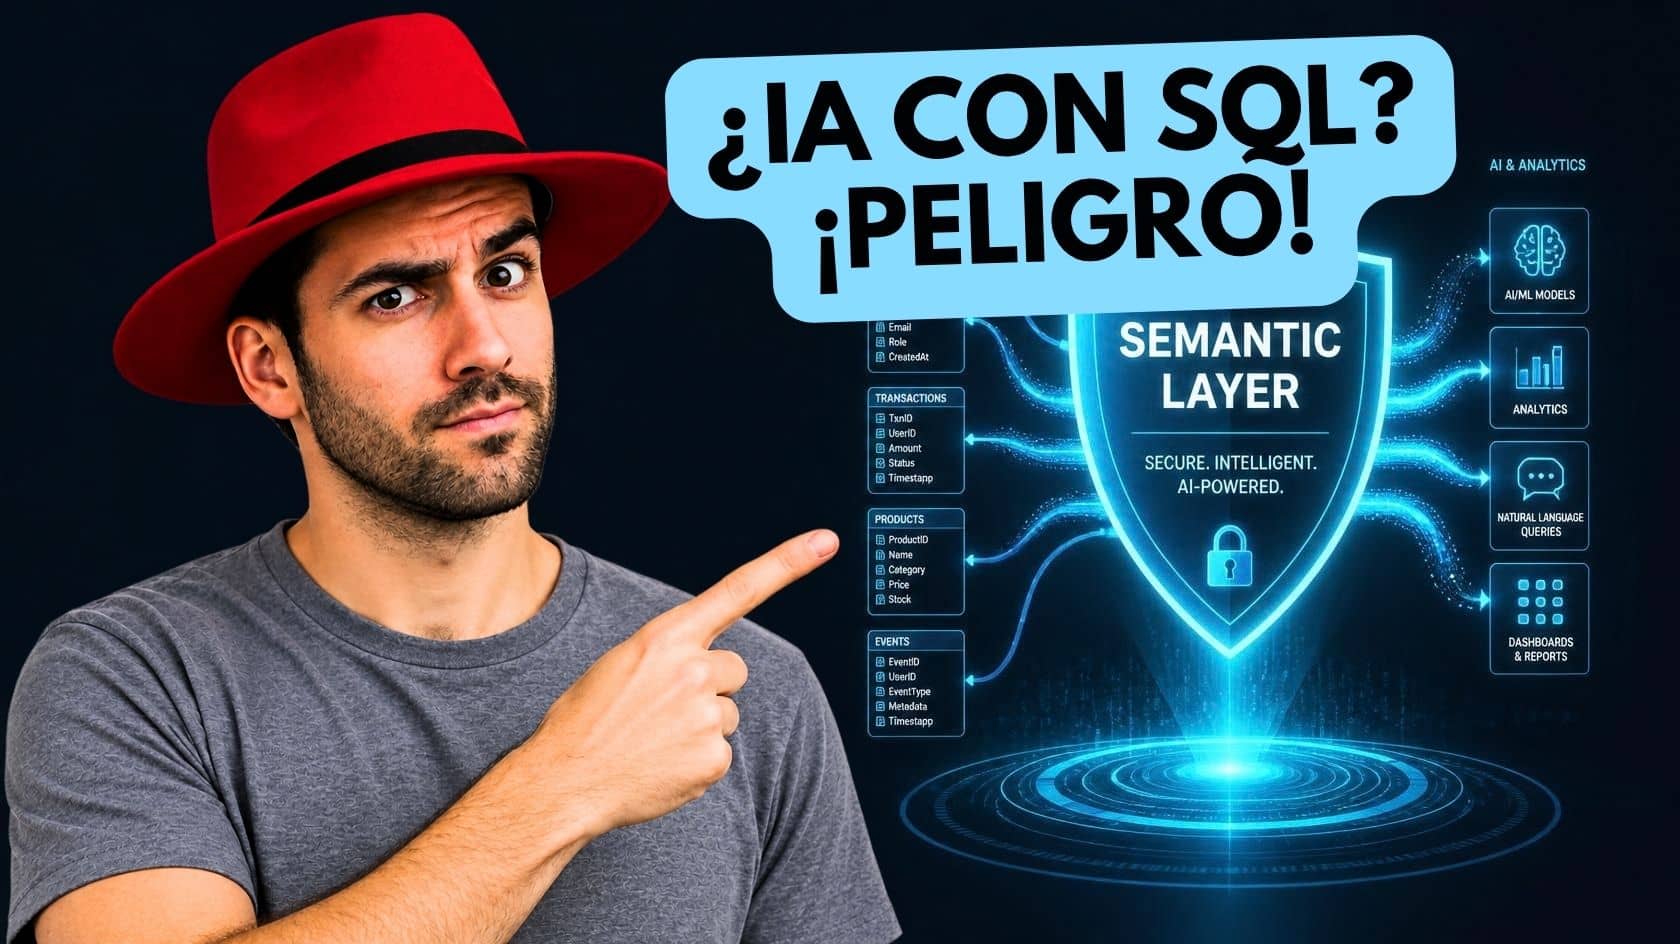
Una consulta SQL puede ejecutarse sin errores, devolver resultados aparentemente razonables y, aun así, proporcionar cifras financieras incorrectas. El problema no siempre está en el modelo de inteligencia artificial, en la base de datos o en la infraestructura. En muchos casos, el verdadero fallo se encuentra en la ausencia de reglas empresariales explícitas, controles de acceso y mecanismos de validación que conecten la IA con la realidad de la organización.
Por eso, diseñar una arquitectura de datos para IA no consiste simplemente en conectar un modelo de lenguaje con una base de datos. El reto es construir un sistema capaz de utilizar la inteligencia artificial sin perder la precisión, la seguridad y la trazabilidad que exige un entorno empresarial.
Vamos a ver cómo diseñar una arquitectura de datos antifrágil para inteligencia artificial, qué problemas aparecen al generar SQL automáticamente, cómo funcionan las capas semánticas y el protocolo MCP, y qué controles necesita un sistema antes de llegar a producción.
Contenidos
¿Qué es una arquitectura de datos antifrágil para IA?
Una arquitectura de datos antifrágil para IA es un diseño de sistemas que no solo busca evitar errores, sino que también incorpora mecanismos para detectar fallos, limitar sus consecuencias, aprender de ellos y mejorar los controles con el tiempo.
El concepto de antifragilidad va más allá de la resiliencia. Un sistema resiliente intenta recuperarse cuando ocurre un problema. Un sistema antifrágil, además, aprovecha la experiencia de los fallos para reducir su vulnerabilidad futura. Aplicado a la ingeniería de datos, esto significa que una consulta incorrecta no debería limitarse a generar una alerta: debería permitir identificar la causa, reforzar las validaciones y evitar que el mismo problema vuelva a producirse en condiciones similares.
Esta filosofía cobra importancia cuando incorporamos modelos de lenguaje y agentes de inteligencia artificial a los sistemas de información corporativos. Tradicionalmente, una consulta SQL suele estar diseñada, revisada y ejecutada mediante procesos controlados. Con la IA generativa, una parte de esa lógica puede crearse dinámicamente a partir de una pregunta en lenguaje natural.
La flexibilidad aumenta pero también aparecen nuevas formas de error. El modelo puede interpretar mal una pregunta, elegir una tabla incorrecta, no conocer la granularidad de los datos o aplicar una definición equivocada de una métrica o KPI.
Una arquitectura antifrágil responde a estos riesgos mediante varias capas de protección:
- Contexto empresarial: definiciones explícitas de las métricas, las entidades y las relaciones entre datos.
- Capa semántica: un conjunto gobernado de conceptos y operaciones que la IA puede utilizar.
- Controles de seguridad: permisos, validación de consultas, límites de consumo y protección de información sensible.
- Observabilidad: registros, métricas y trazabilidad de las decisiones y consultas ejecutadas.
- Validación continua: pruebas que detecten errores semánticos, anomalías y desviaciones respecto a los resultados esperados.
- Supervisión humana: aprobación explícita para operaciones sensibles o de alto impacto.
La inteligencia artificial puede interpretar una necesidad y proponer una solución, pero la arquitectura debe determinar qué acciones están permitidas y bajo qué condiciones pueden ejecutarse.
El problema de confiar ciegamente en la inteligencia artificial
Para entender el por qué de estos controles, conviene distinguir entre dos tipos de sistemas: los modelos probabilísticos y las bases de datos deterministas.
Un modelo de lenguaje genera respuestas a partir de patrones aprendidos y de la información disponible en su contexto. Aunque puede producir razonamientos y código de gran calidad, sus respuestas no constituyen una garantía matemática de corrección.
Una base de datos relacional, en cambio, ejecuta las operaciones definidas por una consulta siguiendo las reglas de su motor. Si una sentencia válida suma cinco veces el mismo importe, la base de datos no tiene por qué detectar que el resultado contradice la realidad del negocio. Ha realizado exactamente la operación solicitada.
Esta diferencia explica uno de los riesgos más importantes de la IA aplicada a los datos: un error semántico puede producir un resultado técnicamente válido.
Imaginemos que una empresa pregunta a un asistente de IA cuánto ha facturado durante el último trimestre. El modelo localiza una tabla de pedidos y otra con sus líneas de detalle, genera una consulta, la ejecuta y devuelve una cifra. Todo parece funcionar correctamente.
Sin embargo, si el asistente suma el importe total de cada pedido después de unirlo con sus líneas de detalle, puede contar varias veces el mismo ingreso. La respuesta se presenta con apariencia de precisión, pero la métrica es incorrecta.
Este problema es especialmente peligroso porque los sistemas tradicionales de monitorización pueden no detectarlo. La consulta se ejecuta, no se producen excepciones y el resultado puede encontrarse dentro de un rango que parece razonable.
Por tanto, la pregunta importante no es únicamente si una IA puede generar SQL. La pregunta es cómo garantizar que ese SQL respeta el significado de los datos y las reglas económicas de la empresa.
Spider 2.0: por qué el Text-to-SQL empresarial es más difícil de lo que parece
Los benchmarks de generación de SQL permiten observar la diferencia entre resolver ejercicios relativamente acotados y trabajar con entornos empresariales complejos.
El benchmark Spider 2.0, presentado en 2024, evalúa 632 tareas de flujos de trabajo SQL basadas en casos de uso empresariales reales. Estos escenarios pueden involucrar bases de datos con más de mil columnas, diferentes dialectos SQL, metadatos, documentación y código adicional necesario para comprender el entorno.
En los resultados iniciales publicados por sus autores, el framework basado en o1-preview resolvió el 17 % de las tareas de Spider 2.0, frente al 91,2 % obtenido en Spider 1.0. En una versión posterior de los resultados del artículo, la cifra para Spider 2.0 se actualizó al 21,3 %. Estas cifras corresponden a configuraciones y evaluaciones concretas, no a una tasa universal de acierto de todas las herramientas de IA. Fuente: artículo de Spider 2.0 y resultados publicados en ICLR 2025.
La conclusión no es que la IA sea inútil para generar SQL. Es que la complejidad del entorno importa enormemente.
En una demostración preparada, el modelo puede disponer de pocas tablas, nombres descriptivos y relaciones evidentes. En una organización real, en cambio, puede encontrar esquemas heredados, columnas con nombres ambiguos, varias representaciones de una misma entidad y definiciones de negocio que no están documentadas.
A esto se suma que una pregunta aparentemente sencilla puede exigir varios pasos: localizar las tablas correctas, interpretar sus relaciones, comprender las reglas de cálculo, consultar documentación y validar el resultado.
Por ese motivo, una arquitectura empresarial no debería depender exclusivamente de la capacidad del modelo para deducir la estructura y el significado de los datos en cada petición. Es preferible proporcionarle un contexto gobernado y herramientas controladas que reduzcan el espacio de posibles errores.
La trampa fan-out: cuando una consulta SQL correcta devuelve cifras equivocadas
Uno de los errores que mejor ilustran el problema es el fan-out, que aparece cuando una combinación de tablas multiplica las filas de una entidad respecto a la granularidad original.
Imagina una tienda que tiene una tabla de pedidos con el importe total de cada compra y otra tabla que almacena los artículos incluidos en cada pedido. La primera tabla contiene esta información:
| Pedido | Importe total |
|---|---|
| P001 | 100 € |
La tabla de detalle contiene cinco artículos asociados al mismo pedido. Cuando hacemos un JOIN entre ambas tablas, el resultado puede ser el siguiente:
| Pedido | Artículo | Importe total |
|---|---|---|
| P001 | A | 100 € |
| P001 | B | 100 € |
| P001 | C | 100 € |
| P001 | D | 100 € |
| P001 | E | 100 € |
El problema aparece si después ejecutamos una agregación como esta:
SELECT SUM(p.importe_total) AS ingresos
FROM pedidos p
JOIN lineas_pedido l
    ON p.id_pedido = l.id_pedido;
El resultado será de 500 €, aunque el pedido original tenía un importe de 100 €. El JOIN ha multiplicado el importe del pedido por el número de líneas asociadas.
La base de datos no ha cometido ningún error. La consulta es sintácticamente válida y el motor ha aplicado correctamente las operaciones solicitadas. El fallo consiste en haber sumado una métrica de cabecera después de cambiar su granularidad.
Este problema puede afectar a ingresos, costes, márgenes, número de clientes y cualquier otra métrica que se agregue después de una combinación inadecuada de tablas.
Cómo evitar el fan-out en una arquitectura de datos para IA
La solución no consiste únicamente en añadir instrucciones al prompt del modelo. Es necesario establecer controles estructurales que reduzcan la posibilidad de generar agregaciones incorrectas.
- Cada entidad debe tener una granularidad documentada. Una tabla de pedidos puede contener una fila por pedido, mientras que una tabla de detalle contiene una fila por artículo. Esta distinción debe formar parte del contexto que utiliza el asistente.
- Las métricas deben incluir reglas explícitas de cálculo. El importe total de los pedidos no debería poder agregarse libremente después de cualquier combinación de tablas. La arquitectura debe conocer cuándo una operación conserva la granularidad original y cuándo introduce duplicados.
- Hay que validar los resultados mediante pruebas. Algunas comprobaciones útiles son comparar los totales antes y después de una combinación, verificar las claves únicas y detectar cambios inesperados en el número de filas.
- Cuando una métrica crítica pueda calcularse mediante una definición previamente validada, es preferible ofrecerla como una operación gobernada en lugar de permitir que el modelo invente la consulta completa.
La diferencia es importante: en vez de confiar en que la IA recuerde cómo calcular los ingresos, diseñamos un sistema que le proporciona una operación cuyo significado ya está definido.
La capa semántica: el puente entre el lenguaje de negocio y los datos
Una capa semántica proporciona una representación coherente de las entidades, métricas, dimensiones y relaciones de una organización. Su función es evitar que cada consumidor tenga que reconstruir por su cuenta el significado de los datos.
Por ejemplo, distintas áreas de una empresa pueden interpretar de manera diferente conceptos como ingresos, clientes activos, pedidos completados o margen bruto. Incluso cuando utilizan las mismas tablas, pueden aplicar filtros, periodos o reglas de exclusión diferentes.
Si conectamos directamente una IA con todas esas tablas, le estamos pidiendo que descubra esas convenciones y las aplique correctamente en cada consulta. El problema es que parte de ese conocimiento puede ser tácito, estar repartido entre informes o depender de decisiones que nunca se documentaron.
Una capa semántica permite centralizar esas definiciones. En lugar de ofrecer acceso indiscriminado a cientos de tablas, el sistema expone conceptos empresariales con reglas conocidas.
Por ejemplo, una herramienta podría ofrecer operaciones como:
- Obtener los ingresos netos por mes.
- Calcular el margen bruto por categoría de producto.
- Consultar el número de clientes activos durante un periodo.
- Comparar los pedidos completados entre dos trimestres.
- Desglosar una métrica por región comercial.
Cada operación debería definir sus parámetros, las reglas de cálculo, las dimensiones permitidas y las restricciones aplicables.
Así, la IA deja de tener que inventar toda la lógica de negocio y pasa a seleccionar la operación que mejor responde a la pregunta del usuario.
¿Qué debería contener una buena capa semántica?
Una implementación empresarial debería contemplar, como mínimo, cinco elementos.
1. Definiciones de métricas. Cada indicador debe contar con una fórmula, una descripción, unas unidades y unas reglas de inclusión y exclusión.
2. Modelo de entidades y relaciones. Es necesario conocer cómo se relacionan clientes, pedidos, productos, facturas y otras entidades, incluyendo las cardinalidades y las claves relevantes.
3. Dimensiones y filtros permitidos. La arquitectura debe especificar por qué atributos se puede desglosar una métrica y qué filtros son válidos.
4. Reglas de acceso. No todos los usuarios o agentes deberían poder consultar los mismos datos. Los permisos deben aplicarse de forma coherente con la identidad y el contexto de la petición.
5. Pruebas de consistencia. Las métricas deben validarse con ejemplos conocidos y contrastarse con los resultados de referencia del sistema corporativo.
La capa semántica no elimina automáticamente todos los errores. Una definición puede estar equivocada o una herramienta puede implementarse de forma incorrecta. Su ventaja es que convierte un problema disperso, que podría repetirse en cada consulta, en una lógica centralizada que puede revisarse y probarse.
Arquitectura de referencia: de la pregunta del usuario a la base de datos
Una arquitectura fiable para utilizar IA con datos corporativos debería separar la interpretación de la intención, la selección de operaciones, la autorización y la ejecución.
Un flujo de referencia podría ser el siguiente:
- Usuario
- Asistente de IA
- Capa semántica y herramientas gobernadas
- Validador de políticas y consultas
- Servicio de ejecución controlado
- Base de datos
- Validación y filtrado de resultados
- Respuesta al usuario
Cada componente tiene una responsabilidad específica.
1. El asistente de IA interpreta la petición
El modelo transforma una pregunta en lenguaje natural en una intención estructurada. Por ejemplo, identifica que el usuario quiere consultar los ingresos netos del último trimestre y desglosarlos por región.
En esta fase no necesita tener acceso directo a las tablas de producción. Su función es interpretar la pregunta, solicitar aclaraciones cuando falten datos y seleccionar las herramientas adecuadas.
2. La capa semántica proporciona las operaciones disponibles
El asistente consulta un catálogo de métricas y herramientas autorizadas. Puede encontrar una operación para obtener ingresos por región y periodo, junto con sus parámetros y restricciones.
Si la pregunta solicita una métrica que no existe o cuya definición no está aprobada, el sistema debería reconocer esa limitación en lugar de improvisar una fórmula potencialmente incorrecta.
3. El validador aplica las políticas
Antes de ejecutar una operación, un componente independiente comprueba que la petición está autorizada. Puede verificar los parámetros, los recursos accesibles, los límites de consumo y las condiciones de seguridad.
Es importante que estas restricciones se apliquen en el sistema de ejecución, no únicamente mediante instrucciones al modelo. Un prompt puede ayudar a orientar el comportamiento de la IA, pero no sustituye a un mecanismo real de control de acceso.
4. El servicio de ejecución consulta los datos
El servicio ejecuta exclusivamente las operaciones permitidas y utiliza credenciales con privilegios mínimos. En un sistema de solo lectura, las credenciales no deberían disponer de permisos de escritura, modificación o eliminación.
También deben establecerse límites de tiempo, cuotas y restricciones sobre el volumen de datos que puede devolver cada petición.
5. Los resultados se validan antes de presentarse
El sistema comprueba que la respuesta respeta las restricciones de acceso y que cumple las validaciones previstas. Dependiendo de la métrica, puede contrastar totales, verificar el periodo consultado o detectar anomalías.
El asistente recibe entonces un resultado estructurado y puede explicarlo al usuario. Si la validación falla, la arquitectura debería bloquear o marcar el resultado en lugar de presentarlo como una cifra confirmada.
Esta separación de responsabilidades es la base de un diseño defendible en producción: el modelo interpreta, las herramientas ejecutan operaciones definidas y los controles independientes autorizan o rechazan las acciones.
Model Context Protocol (MCP): cómo conectar la IA con herramientas de datos
El Model Context Protocol (MCP) es un protocolo abierto que estandariza la comunicación entre aplicaciones de IA y sistemas externos. Puede utilizarse para exponer herramientas, recursos y plantillas que permiten a un modelo acceder a información o solicitar operaciones.
Una forma sencilla de entenderlo es compararlo con un conector estandarizado. En lugar de desarrollar una integración completamente diferente para cada aplicación de IA y cada sistema, MCP proporciona convenciones comunes para descubrir y utilizar capacidades externas.
En una arquitectura de datos, un servidor MCP podría exponer herramientas para consultar métricas, recuperar documentación de tablas, obtener definiciones semánticas o solicitar informes autorizados.
Por ejemplo, en lugar de permitir que el modelo genere cualquier sentencia SQL, podemos ofrecer una herramienta con una interfaz definida:
{
  "name": "consultar_ingresos",
  "description": "Obtiene ingresos por periodo y región",
  "inputSchema": {
    "type": "object",
    "properties": {
      "fecha_inicio": {
        "type": "string"
      },
      "fecha_fin": {
        "type": "string"
      },
      "region": {
        "type": "string"
      }
    },
    "required": [
      "fecha_inicio",
      "fecha_fin"
    ]
  }
}
Este ejemplo define la interfaz de una herramienta, pero no implementa por sí mismo las reglas de negocio, los permisos ni la consulta SQL que se ejecutará.
Cuando el usuario pregunta por los ingresos de una región durante un trimestre, el modelo puede seleccionar la herramienta y proporcionar los parámetros correspondientes. El servidor recibe la solicitud, valida los datos, aplica las políticas y ejecuta la lógica previamente implementada.
La ventaja es que se reduce la libertad del modelo para improvisar operaciones. En lugar de recibir una consulta SQL arbitraria, el sistema recibe una petición estructurada que puede validarse antes de ejecutarse.
Sin embargo, es importante no atribuir al protocolo capacidades que no proporciona por sí solo. MCP no es un firewall, no garantiza la corrección semántica de las métricas y no convierte automáticamente una base de datos en un sistema seguro. La seguridad depende de la implementación del servidor, de sus permisos, de la validación de entradas, de la gestión de credenciales y de los controles de ejecución. La documentación oficial de MCP también destaca la importancia de validar las entradas y aplicar controles de acceso y limitación de solicitudes.
Caché semántica: reducir consultas y reutilizar resultados
Una arquitectura de IA también puede incorporar una caché semántica para reutilizar resultados cuando dos peticiones sean equivalentes desde el punto de vista empresarial.
Por ejemplo, si varios usuarios autorizados solicitan los ingresos netos de una región para el mismo periodo y bajo las mismas reglas, podría ser posible reutilizar un resultado calculado anteriormente.
No obstante, esta optimización exige cautela. Dos preguntas que parecen iguales pueden diferir por permisos, filtros, zona horaria, versión de la definición de una métrica o frescura de los datos.
Por ello, una caché semántica debería considerar, al menos, la identidad y el ámbito de acceso del usuario, los parámetros normalizados, la versión de la métrica, la política de caducidad y los requisitos de actualización de los datos.
La caché puede reducir consultas repetidas y costes de procesamiento, pero el ahorro real dependerá de la tasa de reutilización, de la complejidad de las operaciones y del coste de cada componente. No existe un porcentaje universal de ahorro que pueda garantizarse por utilizar MCP o añadir una caché.
Firewall de consultas: proteger la base de datos en producción
Aunque utilicemos herramientas gobernadas y una capa semántica, es necesario mantener controles defensivos en el camino hacia la base de datos.
El modelo puede seleccionar una herramienta equivocada, enviar parámetros inesperados o intentar ejecutar una operación que excede el alcance autorizado. También pueden existir errores en el código de integración o vulnerabilidades en el propio servidor.
Por ese motivo, el acceso a los datos debe pasar por una capa de validación y autorización independiente.
Controles esenciales de un firewall de consultas
Solo lectura por defecto. Los asistentes de consulta analítica deberían utilizar credenciales sin permisos de escritura. Si un caso de uso necesita modificar información, debe tratarse como un flujo diferente, con controles y autorizaciones adicionales.
Lista de recursos permitidos. Las herramientas deben acceder exclusivamente a las tablas, vistas, métricas y operaciones necesarias para cumplir su función. No conviene exponer todo el catálogo corporativo por defecto.
Validación de parámetros. Los valores de entrada deben validarse por tipo, formato, rango y significado. Los nombres de columnas, las dimensiones y las operaciones disponibles deben proceder de definiciones controladas, no de concatenaciones arbitrarias.
Protección frente a consultas costosas. Es necesario limitar el tiempo de ejecución, el volumen de resultados, el número de peticiones y el consumo de recursos. Una consulta válida puede ser económicamente inaceptable si procesa una cantidad desproporcionada de datos.
Protección de información sensible. Los permisos deben respetar la identidad del usuario y las políticas de acceso a los datos. El enmascaramiento puede ser necesario, pero no sustituye a los controles de autorización ni a la minimización de los datos expuestos.
Registro y trazabilidad. Deben registrarse las herramientas utilizadas, los parámetros relevantes, las decisiones de autorización, los errores y los identificadores de ejecución. Los registros han de diseñarse para evitar almacenar innecesariamente información personal o secretos.
Validación de resultados. Las operaciones críticas necesitan comprobaciones que permitan detectar valores imposibles, duplicaciones inesperadas o desviaciones respecto a reglas de negocio conocidas.
Un buen diseño no depende de una única barrera. Combina permisos mínimos, validación, aislamiento, monitorización y mecanismos de recuperación para que un fallo individual no se convierta en un incidente grave.
Niveles de control según el riesgo
No todas las aplicaciones de IA necesitan el mismo grado de restricción. Un entorno de experimentación y un sistema que interviene en operaciones financieras requieren controles diferentes.
Una forma práctica de diseñar la arquitectura consiste en clasificar las operaciones por su impacto potencial.
| Nivel de riesgo | Ejemplo | Controles recomendados |
|---|---|---|
| Bajo | Exploración de datos sintéticos en un entorno aislado | SQL flexible, límites de recursos y registro de actividad |
| Medio | Consultas analíticas sobre datos corporativos | Herramientas gobernadas, capa semántica, permisos por usuario y validación |
| Alto | Consulta de datos personales o elaboración de informes financieros críticos | Acceso restringido, validaciones reforzadas, trazabilidad y controles específicos de aprobación |
| Crítico | Modificación de registros, transferencias o decisiones con consecuencias importantes | Flujo separado de escritura, autorización explícita, revisión humana cuando corresponda y capacidad de reversión |
Esta tabla es una propuesta de diseño, no una clasificación legal universal. La evaluación debe adaptarse al impacto de cada aplicación, a la información tratada y a las obligaciones regulatorias aplicables.
La regla práctica es que la autonomía de la IA no debería aumentar más rápido que la capacidad del sistema para detectar y contener errores. Cuanto mayor sea el impacto de una operación, más rigurosos deben ser sus controles.
Cómo validar una arquitectura de datos para IA antes de producción
Una arquitectura no es fiable simplemente porque sus componentes estén instalados. Es necesario demostrar que las restricciones funcionan y que el sistema produce resultados correctos en escenarios representativos.
Estas son algunas pruebas que conviene incluir en un plan de validación.
1. Pruebas de exactitud semántica
Selecciona preguntas de negocio cuyas respuestas hayan sido calculadas y verificadas previamente. Comprueba que el asistente obtiene los mismos resultados, dentro de las tolerancias definidas.
Incluye preguntas ambiguas, periodos con cambios de calendario, filtros combinados y métricas con reglas de exclusión.
2. Pruebas de granularidad y agregación
Crea casos con relaciones uno a muchos y muchos a muchos. Comprueba que los totales no se multiplican al combinar tablas y que las métricas se agregan correctamente.
Este conjunto de pruebas debería incluir explícitamente el problema fan-out.
3. Pruebas de autorización
Intenta acceder a recursos no permitidos, solicitar columnas restringidas y recuperar datos fuera del ámbito autorizado. El sistema debe rechazar las operaciones incluso cuando el modelo las proponga.
4. Pruebas de resistencia ante entradas maliciosas
Evalúa qué sucede cuando una petición intenta modificar las instrucciones del sistema, obtener información confidencial o inducir al agente a ejecutar operaciones fuera de su función.
La validación debe cubrir tanto el comportamiento del modelo como las barreras implementadas en el servidor y en la base de datos.
5. Pruebas de rendimiento y coste
Mide la latencia de extremo a extremo, el consumo de recursos, el número de consultas, el coste de inferencia y la frecuencia de reutilización de resultados.
No basta con medir el tiempo que tarda el modelo en responder. Hay que contabilizar la búsqueda de contexto, la validación, la ejecución SQL y la preparación de la respuesta final.
6. Pruebas de recuperación
Simula fallos de herramientas, resultados incompletos, timeouts y errores de conexión. Comprueba que el sistema no presenta una respuesta parcial como si estuviera completa y que registra la causa del incidente.
7. Pruebas de regresión
Cada vez que cambien las definiciones semánticas, las herramientas, los permisos o el modelo de IA, vuelve a ejecutar los casos de referencia. Una modificación que mejora una consulta puede introducir errores en otra.
El objetivo es convertir la calidad en una propiedad verificable del sistema, no en una expectativa basada en que el modelo se comporte correctamente.
Observabilidad: detectar los fallos que no generan excepciones
La observabilidad de una arquitectura de IA debe ir más allá de comprobar si el servidor está disponible o si una consulta termina correctamente.
Hay que medir también si las respuestas son correctas, si se respetan las políticas y si el sistema se comporta de manera coherente con las expectativas del negocio.
Entre las métricas que conviene monitorizar destacan:
- Porcentaje de consultas que superan las validaciones semánticas.
- Número de solicitudes bloqueadas por políticas de acceso.
- Frecuencia de resultados anómalos o inconsistentes.
- Latencia total y latencia de cada componente.
- Coste por petición y consumo agregado.
- Porcentaje de consultas que reutilizan resultados en caché.
- Número de errores de herramientas y consultas fallidas.
- Desviaciones respecto a los resultados de referencia.
- Incidentes relacionados con permisos o exposición de información.
Una arquitectura madura debería permitir reconstruir qué preguntó el usuario, qué herramienta seleccionó el modelo, qué parámetros se utilizaron, qué validaciones se aplicaron y qué resultado se devolvió, respetando siempre las políticas de privacidad y conservación de registros.
También conviene establecer procedimientos de respuesta ante incidentes. Si una métrica crítica empieza a producir resultados inconsistentes, el sistema debería poder deshabilitar temporalmente la herramienta afectada, utilizar un cálculo alternativo validado o exigir una revisión manual hasta que se corrija el problema.
La antifragilidad aparece cuando cada incidente se convierte en una mejora concreta: una nueva prueba, una restricción más precisa, una definición semántica corregida o una alerta que detecta el problema antes de que vuelva a afectar al negocio.
Seguridad, trazabilidad y regulación de la inteligencia artificial
La gobernanza técnica también debe considerar el marco regulatorio en el que opera la empresa.
En la Unión Europea, el Reglamento de Inteligencia Artificial establece obligaciones que dependen, entre otros factores, de la función del sistema y de su clasificación de riesgo. Para los sistemas de alto riesgo sujetos a esas obligaciones, el marco contempla aspectos como la gestión de riesgos, la calidad de los datos, el registro de actividad, la documentación, la supervisión humana, la robustez y la ciberseguridad. No todas las aplicaciones de IA están sometidas a las mismas obligaciones ni deben considerarse automáticamente sistemas de alto riesgo. Comisión Europea: marco regulatorio de la IA.
Además de la normativa específica sobre IA, una organización debe analizar las obligaciones que le correspondan en materia de protección de datos, confidencialidad, seguridad de la información y conservación de registros.
Desde el punto de vista arquitectónico, esto refuerza la importancia de diseñar desde el principio la identidad de los usuarios, los permisos, la trazabilidad, la gestión de datos sensibles y los procedimientos de revisión.
No basta con incorporar un modelo potente y añadir controles después del despliegue. La seguridad debe formar parte del diseño del sistema.
Qué necesita aprender un ingeniero de datos para diseñar estas arquitecturas
La aparición de agentes de IA no elimina la necesidad de comprender cómo se almacenan, transforman y utilizan los datos. En muchos casos, aumenta la importancia de dominar esos fundamentos porque ahora hay que diseñar sistemas capaces de delegar operaciones sin perder el control.
Si quieres especializarte en arquitecturas de datos preparadas para IA, te recomiendo desarrollar estas competencias en un orden práctico.
1. SQL avanzado y modelado de datos. Domina las combinaciones de tablas, las agregaciones, las funciones de ventana, las claves, la granularidad y los patrones que pueden producir duplicaciones. Debes poder detectar cuándo una consulta es válida desde el punto de vista sintáctico, pero incorrecta desde el punto de vista empresarial.
2. Modelado dimensional y semántica de negocio. Aprende a definir hechos, dimensiones, métricas y relaciones de forma explícita. La IA necesita un modelo coherente del significado de los datos, no solamente una lista de tablas.
3. Python y desarrollo de servicios. Necesitas implementar herramientas, validar parámetros, gestionar errores y construir servicios que conecten los modelos de IA con los sistemas corporativos.
4. Calidad de datos y pruebas automatizadas. Diseña comprobaciones de unicidad, integridad, consistencia, rangos y reconciliación de métricas. Incorpora pruebas de regresión para evitar que los cambios de código o de definiciones semánticas alteren los resultados.
5. Seguridad y arquitectura de permisos. Comprende el principio de mínimo privilegio, la gestión de credenciales, el aislamiento de entornos, el control de acceso y la protección de información sensible.
6. Integración con modelos de lenguaje y herramientas. Aprende cómo funcionan las llamadas a herramientas, la validación de entradas, el manejo de resultados y la separación entre la interpretación del modelo y la ejecución de operaciones.
7. MCP y diseño de interfaces gobernadas. Familiarízate con el protocolo y con la implementación de servidores que expongan capacidades específicas. El objetivo no es aprender un protocolo de memoria, sino saber diseñar integraciones seguras y útiles.
8. Observabilidad y evaluación de sistemas de IA. Mide la exactitud, el coste, la latencia, las tasas de error y la eficacia de los controles. Diseña pruebas que representen el uso real y no únicamente ejemplos preparados para una demostración.
No necesitas dominar todas estas áreas al mismo tiempo. Un buen proyecto de aprendizaje consiste en construir un asistente que consulte un conjunto pequeño de datos, utilice métricas definidas previamente, aplique permisos de solo lectura y supere una batería de pruebas automatizadas antes de ampliar su alcance.
Mi perspectiva: el verdadero valor no está en generar más SQL
Desde mi perspectiva como profesional, una de las distinciones más importantes que debemos mantener es la que existe entre automatizar la escritura de código y responsabilizarnos del resultado que produce ese código.
La IA puede acelerar tareas que antes requerían escribir consultas manualmente, buscar documentación o construir integraciones. Sin embargo, esa velocidad no resuelve por sí sola los problemas de modelado, calidad, seguridad y semántica empresarial.
En un proyecto de datos, el error más peligroso no siempre es el que rompe una ejecución. A menudo es el que produce un resultado plausible, se integra en un informe y termina influyendo en una decisión.
Por eso, cuando evalúo una arquitectura de este tipo, no me quedo únicamente con la pregunta de si el modelo puede generar una consulta. Me interesa saber qué sucede cuando elige una tabla equivocada, duplica una métrica, solicita información restringida o recibe una petición ambigua.
También me interesa comprobar si el sistema puede explicar qué operación ha ejecutado, por qué estaba autorizada y cómo se ha validado el resultado.
Estas preguntas desplazan el foco desde la demostración hacia la ingeniería real. En lugar de confiar en que el modelo acierte, diseñamos un entorno en el que los errores tienen menos probabilidades de producirse y, cuando aparecen, pueden detectarse y contenerse.
Esta es la diferencia entre añadir IA a una infraestructura existente y diseñar una arquitectura preparada para operar con IA de forma responsable.
El futuro de la ingeniería de datos exige sistemas verificables
La arquitectura de datos para IA no debería construirse alrededor de la idea de que los modelos serán siempre capaces de interpretar correctamente cualquier esquema, métrica o regla empresarial. Debe partir de la realidad de que los modelos pueden equivocarse y de que algunos errores no producen excepciones técnicas.
Una arquitectura antifrágil combina una capa semántica bien definida, herramientas gobernadas, controles de acceso independientes, validaciones de resultados, observabilidad y procedimientos de recuperación. Protocolos como MCP facilitan la integración entre los modelos y las herramientas, pero la corrección y la seguridad siguen dependiendo de cómo se diseñen e implementen esas herramientas.
El objetivo final no es impedir que la inteligencia artificial utilice los datos. Es permitir que los utilice con límites claros, resultados verificables y un nivel de autonomía proporcional al riesgo.
Para los ingenieros de datos, esto abre una línea de especialización que combina SQL, modelado, calidad, seguridad y arquitectura de sistemas de IA. La ventaja profesional no estará únicamente en saber conectar un modelo con una base de datos, sino en saber construir el sistema que permite utilizarlo sin perder el control.
La IA puede generar consultas en segundos. Diseñar la arquitectura que garantiza que esas consultas tengan sentido para el negocio sigue siendo un trabajo de ingeniería.
Si quieres desarrollar esa visión de conjunto y avanzar hacia un perfil de ingeniero de datos capaz de diseñar sistemas completos, puedes conocer mi programa Ingeniero de Datos, donde trabajo los fundamentos y las competencias necesarias para progresar en esta profesión.
Preguntas frecuentes sobre arquitectura de datos para IA
¿Qué es una arquitectura de datos para inteligencia artificial?
Es el conjunto de componentes, modelos de datos, interfaces y controles que permiten a los sistemas de inteligencia artificial acceder y utilizar datos de forma segura y coherente. En entornos empresariales puede incluir una capa semántica, herramientas gobernadas, controles de acceso, validaciones y mecanismos de observabilidad.
¿Por qué no es recomendable conectar directamente una IA a una base de datos de producción?
Porque el modelo puede generar consultas que se ejecuten correctamente, pero utilicen tablas, relaciones o métricas equivocadas. Además, un acceso demasiado amplio aumenta el riesgo de exposición de información sensible, consultas costosas y operaciones no autorizadas. Es preferible utilizar herramientas controladas y permisos mínimos.
¿Qué es una capa semántica para inteligencia artificial?
Es una capa que define de forma centralizada el significado de las métricas, las dimensiones y las relaciones empresariales. Permite que una IA utilice conceptos como ingresos netos o clientes activos sin tener que inventar su fórmula y sus reglas en cada consulta.
¿Qué función tiene MCP en una arquitectura de datos para IA?
El Model Context Protocol permite estandarizar la comunicación entre aplicaciones de IA y herramientas externas. Puede utilizarse para exponer operaciones de consulta y otros servicios de datos mediante interfaces estructuradas. Sin embargo, necesita controles de seguridad y validación adicionales.
¿Cómo se puede evitar que una IA genere consultas SQL incorrectas?
No existe una garantía absoluta basada únicamente en instrucciones al modelo. La estrategia más robusta combina definiciones semánticas explícitas, herramientas con parámetros validados, permisos de mínimo privilegio, pruebas automatizadas, comprobaciones de granularidad y monitorización de resultados.
Arquitecto de Datos con más de 10 años de experiencia en el sector del Big Data. Autor de cursos de formación en tecnologías Big Data, Cloud y Streaming completados por más de 7000 alumnos en Udemy y otras plataformas. Miembro de la Apache Software Foundation desde 2019.